Claude Opus 5.5 是怎麼做出視頻的
整理版優先睇
Opus 5.5 做影片唔係內建影片模型,而係寫程式逐幀畫出嚟;佢身兼導演同程序員,靠長時間規劃同寫代碼嘅能力,將文字、圖片同文件變成可渲染嘅動畫。
呢篇文係一篇技術拆解,背景係 Anthropic 喺 2026 年 9 月 22 日發佈 Claude Opus 5.5 之後,社交媒體出現一批「一句話做出嚟」嘅動畫影片。好多人以為 Claude 有咗影片模型,或者以為 AI 寫幾行代碼就會自動生成影片,作者想釐清呢兩種誤解:Opus 5.5 睇得明文字、圖片同文件,但睇唔到影片,輸出亦只有文字;嗰啲影片其實係佢寫程式畫出嚟,程式規定每一幀係點,瀏覽器或渲染軟件逐幀畫好,再拼成 MP4。
作者自己都做咗一條教學影片,同文一齊發,並公開咗佢用嘅提示詞,所以文章既有自身實測,也有引用官方發佈、HeyGen 工程文章、OrcaRouter 拆解同社區案例。佢整理角度唔係吹奏模型萬能,而係拆開成五步:規劃、畫面、動作、聲音、拍攝與合成,講清楚邊啲位由 Opus 5.5 寫代碼,邊啲位交畀外部工具。
整體結論係:Opus 5.5 做影片時身兼導演同程序員,負責規劃、寫代碼、調度工具;瀏覽器同 FFmpeg 就負責將代碼變成畫面同文件。佢之所以得,係因為最強嘅長時間規劃同寫代碼能力,所以呢類影片文字準、時間準、改得動;但寫實畫面、人臉動物同大製作仍然弱,要接影片模型或實拍補位。
- 結論先講清楚:Opus 5.5 冇內建影片生成能力,佢係寫程式逐幀畫出影片,再交瀏覽器同 FFmpeg 渲染合成;Anthropic 官方發佈文章亦冇提過任何影片能力。
- 核心流程得五步:規劃腳本同分鏡、用代碼畫畫面、用時間軸固定動作、做配音同音效、再用無頭瀏覽器逐幀截圖交 FFmpeg 合成。
- 同 Seedance、可靈呢類影片模型最大差異:代碼影片每個字都準、改一處只改一行、可精確對旁白、重複渲染完全一樣;但寫實人臉、動物同大場面就明顯輸蝕。
- 最值得啟發嘅位:模型唔係一鍵變片,而係自己內部完成規劃、分工同返工;所以真正值錢嘅係長時間規劃、多文件協作同可驗證嘅代碼流程。
- 可行動點:想試就裝 Claude Code、Node.js、Chrome 同 FFmpeg,再用 HyperFrames 或 Remotion 嘅 skill 包;提示詞要交代素材、繪製方式、視覺風格、配音工具同內容要求。
教學影片提示詞模板
作者實測用嘅提示詞:素材(Markdown 文件)同 Gemini API Key(.env 文件)見附件;用 JS + Canvas 繪製、手繪卡通風格、有動效;配音用 Gemini 3.8 Flash TTS;要通俗易懂、開頭吸引人、看完有收穫。
HyperFrames skill 包
HeyGen 開源,幫 Claude Code、Cursor、Codex 等編程代理按固定流程做片:規劃、寫 HTML、接入可跳轉動畫、加素材、代碼檢查、預覽、渲染。安裝同渲染指令:npx skills add heygen-com/hyperframes;npx hyperframes render。
Remotion 官方 skill 包
用 React 組件寫影片嘅開源框架,官方 skill 可在項目目錄運行 npx remotion skills add 安裝。
代碼影片五步流程
規劃腳本同分鏡 → 用代碼畫畫面 → 用時間軸固定動作 → 做配音同音效 → 無頭瀏覽器逐幀截圖,再交 FFmpeg 合成 MP4。
先講結論:唔係影片模型,係寫程式畫片
Anthropic 喺 2026 年 9 月 22 日發佈 Claude Opus 5.5 之後,社交媒體好快出現一批「一句話做出嚟」嘅動畫影片。好多人第一反應係 Claude 終於有影片模型,或者 AI 寫幾行代碼,影片就會自己彈出嚟,但呢兩種理解都唔準。
Opus 5.5 睇唔到影片,輸出亦只有文字
Opus 5.5 可以讀文字、圖片同文件,但佢睇唔到影片,輸出亦只有文字。嗰啲影片其實係佢寫嘅程式畫出嚟:程式規定每一幀長咩樣,瀏覽器或渲染軟件逐幀畫好,再拼成一個 MP4 文件。
身兼導演同程序員兩個角色
Anthropic 官方發佈文章都冇提過任何影片能力,重點仍然係寫代碼、操作電腦同知識工作。所以更準確嘅講法係:做呢啲影片時,Opus 5.5 身兼導演同程序員兩個角色。
作者實測:一條教學片提示詞拆到五步流程
作者自己都做咗一條教學影片,同文章一齊發,所以呢篇唔止係二手整理,仲有自身實測。佢公開嘅提示詞講明素材、繪製方式、視覺風格、配音工具同內容要求,等模型唔使亂猜。
幫我做一個教學影片,素材(Markdown 文件)同 Gemini API Key(.env 文件)見附件。
用 JS + Canvas 繪製,手繪卡通風格,有動效,配音用 Gemini 3.8 Flash TTS。
要通俗易懂,開頭要吸引人,看完有收穫。
JS + Canvas 對應代碼影片路線
成條流程可以拆成五步:規劃、畫面、動作、聲音、拍攝與合成。帶底色嘅三步係 Opus 5.5 寫嘅代碼,其餘交畀外部工具;配音除咗做音軌,仲會做全片時鐘。
- 1 規劃:先寫腳本,再拆成分鏡,講清每個鏡頭畫咩、幾長、配咩話。
- 2 畫面:用 HTML、CSS、SVG、three.js、p5.js 或 Manim 等代碼畫形狀、顏色同角色,唔一定要現成素材。
- 3 動作:用 GSAP 或 Remotion 寫時間軸,將「第幾秒邊個點動」固定落嚟。
- 4 聲音:講旁白交 TTS,拿每個字嘅時間戳;MV 就用歌曲本身做時鐘。
- 5 拍攝與合成:用無頭瀏覽器逐幀截圖,再交 FFmpeg 混音同輸出 MP4。
點樣逐幀拍片:由代碼到 MP4 嘅關鍵
影片本質上係一串連續播放嘅靜態圖片,例如每秒 30 幀,10 秒就係 300 張圖。所以問題只有一個:第 N 幀應該長咩樣?Opus 5.5 就係寫一個可以回答呢條問題嘅程式。
第 N 幀應該長咩樣
畫面通常用網頁技術畫,動作靠時間軸固定。以 GSAP 為例,每一行都係指令:第 2 秒星星彈出,第 3 秒角色向右走 400 像素。時間軸可以暫停同跳到任意時間點,正好配合逐幀截圖。
tl.from(star, { scale: 0 }, 2)
tl.to(character, { x: 400 }, 3)最後由無頭瀏覽器化身「攝像機」,唔按播放鍵,而係跳到第 0 秒截圖、跳到 1/30 秒再截圖。為咗每次一樣,代碼有三條禁令:唔可以讀當前時間、唔可以用冇固定種子嘅隨機數、渲染時唔可以聯網。
唔按播放鍵
唔可以讀當前時間
唔可以用冇固定種子嘅隨機數
渲染時唔可以聯網
同影片模型點揀:代碼路線 vs 像素路線
Seedance、可靈呢類模型直接生成像素,Opus 5.5 生成嘅係代碼。兩條路線擅長嘅事唔同,唔係邊個全面取代邊個。
- 畫面來源:代碼影片由程式算出每一幀;影片模型直接生成像素。
- 文字準確度:代碼影片每個字都準;影片模型容易出現錯字、亂碼。
- 改動成本:代碼影片改一行代碼,其他位唔鬱;影片模型通常要重新生成。
- 對旁白:代碼影片可以精確到幀;影片模型好難精確控制。
- 寫實畫面:代碼影片對人臉、動物、寫實場景弱;影片模型強。
- 重複性:同一輸入,代碼影片每次渲染一樣;影片模型每次都不同。
兩條路線擅長嘅事唔同
兩條路線可以混住用:Claude 做編排器,透過 MCP 調影片模型,拿回生成片段再剪入自己時間軸;亦可以先代碼渲染鏡頭,再交 Runway Aleph 改成寫實風格。
Claude 做編排器
透過 MCP 調影片模型
侷限、成本同落地建議
代碼影片適合動效、圖表同講解類內容,但唔係萬能。活物畫唔好、太空場景容易過曝、額度消耗大,審美仍然要人把關,亦要有一個執行代碼嘅環境。
- 活物:動物同人臉近看只係粗糙幾何形狀,呢類鏡頭要靠影片模型或實拍。
- 過曝:太空等場景常亮到發白,提示詞要專門要求真實顏色。
- 成本:有創作者做 3 分鐘帶旁白短片,用咗每週 Claude 額度約 7%;單條 3D 提示詞亦可能撞輸出長度上限。
- API 價格:Opus 5.5 每百萬輸入 Token 4 美元、每百萬輸出 Token 20 美元。
- 審美:Wes Bos 認為動效本身唔算出色,出色係佢做得到;要決定展示咩、將風格做到位,最好畀素材庫同風格指引。
- 門檻:要 Claude Code、Node.js、Chrome 同 FFmpeg。
現成工具有 HyperFrames 同 Remotion,兩者都開源,亦可以配合 Claude Code。HyperFrames 由 HeyGen 開源,影片寫成普通 HTML,動畫默認 GSAP,渲染靠 Puppeteer 加 FFmpeg;Remotion 用 React 組件寫影片,同樣有官方 skill 包。
HyperFrames
Remotion
npx skills add heygen-com/hyperframes # 幫代理裝上技能包
npx hyperframes render # 渲染出 MP4
HeyGen 提過,佢哋早期試過 Remotion,發現 React 框架限制越多,智能體產出越保守、越雷同;換回純 HTML 之後,創意先返嚟。呢個係佢哋自己經驗,揀工具時可以參考。
框架限制越多,產出越保守、越雷同
先講結論:條片係 Opus 5.5 寫嘅程式畫出嚟嘅。
2026 年 9 月 22 日,Anthropic 發佈咗 Claude Opus 5.5。之後一個禮拜,社交媒體上冒出咗一大批「一句話就做到」嘅動畫片:15 秒嘅動效作品集、有旁白嘅科普短片、配咗鋼琴曲嘅動態設計,仲有一支兩分半鐘嘅 MV。
見到呢啲片,有人以為 Claude 都有影片模型,亦有人以為 AI 寫幾行 code,條片就會自己彈出嚟。呢兩種理解都唔準確。
Opus 5.5 識讀文字、圖片同檔案,但睇唔到影片,輸出亦只有文字。嗰啲片全部都係佢寫嘅程式畫出嚟:程式規定每一格係咩樣,瀏覽器或者渲染軟件就按程式將幾千格逐格畫好,再拼成一個 MP4 檔案。
Anthropic 嘅發佈文章[1]入面亦冇提到任何影片能力,重點講嘅係寫 code、操作電腦同知識工作。所以更準確嘅講法係:做呢啲片嗰陣,Opus 5.5 身兼導演同程式員兩個角色。
我做呢條片用嘅提示詞
我都做咗一條教學片,會同呢篇文章一齊發。下面係我製作呢條片時用嘅提示詞:
幫我做一個教學片,素材(Markdown 檔案)同 Gemini API Key(.env 檔案)見附件。
用 JS + Canvas 繪製,手繪卡通風格,有動效,配音用 Gemini 3.8 Flash TTS。
要通俗易明,開頭要吸引人,睇完有得着。
呢段提示詞交代咗素材、繪製方式、視覺風格、配音工具同內容要求。JS + Canvas 對應前面講嘅程式碼影片路線:畫面由程式繪製,配音交畀語音工具。最後一句就明確咗教學片要達到嘅效果:吸引人睇落去,亦要令人睇得明、記得住。
原理:寫程式,逐格影相,拼成影片
影片其實就係一連串連續播放嘅靜態圖片。常見係每秒 30 張(30 格),10 秒嘅片就係 300 張圖,播得夠快,人眼就會睇成連貫嘅動作。
所以做一段片,要回答嘅問題只有一個:第 N 格應該係咩樣。Opus 5.5 做嘅事,就係寫一個可以回答呢個問題嘅程式。隨便畀佢一個時間點,例如第 2.5 秒,佢就可以畫出嗰一刻嘅完整畫面。
成個流程可以拆成五步:規劃、畫面、動作、聲音、拍攝同合成(圖入面將拍攝同合成畫成咗兩格)。先睇全流程圖,後面再逐步拆開講。
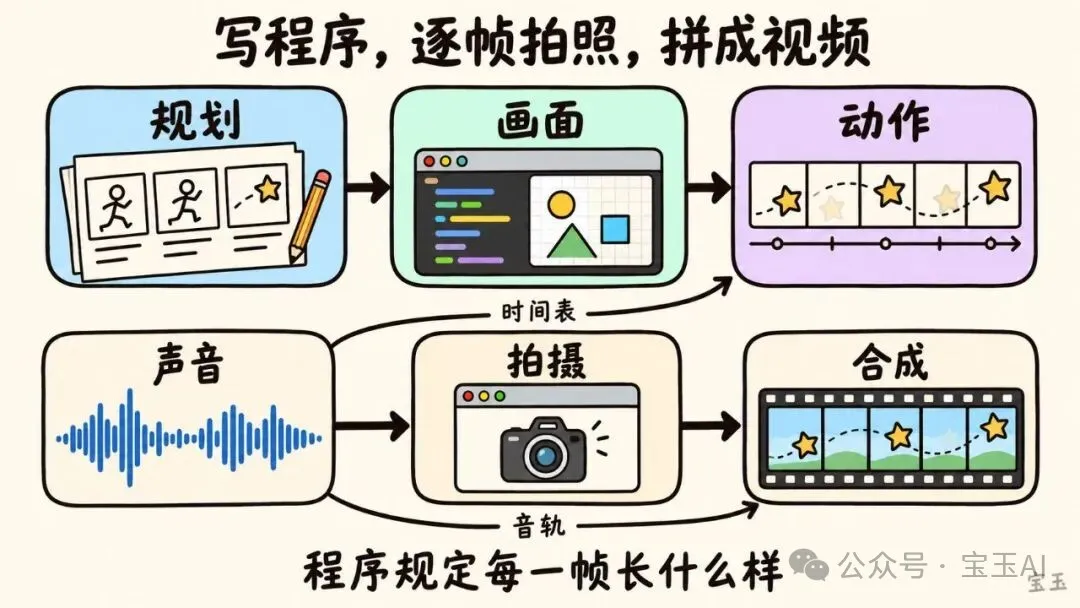
有底色嘅三步係 Opus 5.5 寫嘅程式碼,其餘係外部工具。配音有兩個去處:畀動作提供時間表,亦會作為音軌交畀 FFmpeg。
第一步:規劃,先寫劇本同分鏡
收到「幫我做條片」呢類需求,Opus 5.5 會先寫劇本,再將劇本拆成一個個鏡頭,亦即係分鏡。每個鏡頭都要寫清楚畫咩、持續幾久、配咩對白。
公開咗全部源碼嘅一個例子,係一支叫《I'm Upping My P(doom)》嘅 MV,長 156.6 秒,項目名叫 PDoomVideo,源碼放咗喺 GitHub(OrcaRouter 嘅拆解文章[2])。作者喺說明文件入面寫,佢只指定咗一個角色形象,要求每句歌詞都配上有趣嘅畫面同轉場,冇畀任何具體場景,其餘全部由模型生成。
模型第一輪做完之後,仲幫自己寫咗一份分鏡規範 STORYBOARD.md,入面規定咗:
• 固定嘅角色設計,成套片都唔變 • 配色由暖奶油色到太空紫,再到警報紅,最後返返轉頭 • 每個鏡頭入面都一定要有嘢喺度動,畫面入面唔放文字 • 角色表情要慢慢漸變過去,唔可以突然跳變 • 每次切換鏡頭都要由動作帶出嚟,例如一啖咬落去變黑屏、一次墜落、鏡頭穿過一隻眼
然後佢按章節分工:同時派出多個子智能體(subagent,主智能體派出去分頭做嘢嘅副手),每個子智能體寫一個 JavaScript 檔案,負責時間軸上嘅一段。
說明文件亦有寫,呢條片前後生成咗兩輪。網上講嘅「一句話一次成型」,意思係用戶只發咗一句話;模型自己喺內部完成咗規劃、分工同返工。呢個正正係 Opus 5.5 嘅強項:長時間、多檔案嘅任務都可以一直唔跑偏。Anthropic 嘅發佈文章入面提到,有測試者試過要佢無人看管連續做咗 18 個幾鐘。
第二步:畫面,用程式碼畫出嚟
畫面入面嘅形狀、顏色同角色,全部都由程式碼描述,唔需要現成嘅圖片素材。
最常見嘅寫法係用網頁。文字同色塊用 HTML、CSS 排版,圖標同角色就用 SVG 畫(SVG 係一種用座標同數學描述圖形嘅格式,放大都唔會模糊)。例如下面呢段 SVG,畫嘅係一個青色嘅圓、一粒金色五角星同一個方塊身體:
<svg width="400" height="200">
  <circle cx="60" cy="100" r="40" fill="teal" />
  <polygon points="200,60 212,95 250,95 219,117 231,152 200,130 169,152 181,117 150,95 188,95" fill="gold" />
  <rect x="300" y="80" width="60" height="50" rx="6" fill="#d97757" />
</svg>
做 3D 場景嗰陣,通常會用網頁 3D 庫 three.js,成個場景往往就寫喺一個 HTML 檔案入面。前面嗰支 MV 用嘅係 p5.js(一個面向藝術創作嘅繪圖庫),再加一個水彩筆刷庫,所以畫面有手繪感。
亦有唔經網頁嘅路線。有人叫 Opus 5.5 用 Manim 做編程知識講解片,Manim 係一個專門做數學動畫嘅 Python 庫。開發者 Felix Rieseberg 就將 3D 軟件 Blender 當成 Python 庫嚟用,叫模型直接寫腳本建模、做貼圖。呢類工具自己就可以渲染出畫面。
需要照片級素材嗰陣,亦可以先叫圖像模型生成圖片,再放入網頁度用。
第三步:動作,將每個動作固定喺時間點上
畫面之所以識動,係因為程式碼入面有一張時間表:第幾秒,邊樣嘢,點樣動。常見寫法有兩種。
第一種用 GSAP,一個老牌網頁動畫庫。佢每一行都係一條指令,下面兩行嘅意思係「第 2 秒星星由無到有彈出嚟,第 3 秒角色向右行 400 像素」:
tl.from(star, { scale: 0 }, 2)
tl.to(character, { x: 400 }, 3)
GSAP 嘅時間軸可以暫停,亦可以直接跳到任何一個時間點,後面「逐格影相」嗰步正正需要呢個能力。開源工具 HyperFrames 預設用嘅就係佢。
第二種係 Remotion 嘅寫法。Remotion 係一個用 React 寫片嘅框架,每一格都係格號嘅函數:程式碼攞到「依家係第幾格」,再算出呢一格入面每個元素嘅位置、透明度同顏色。
兩種寫法最後達到嘅效果一樣:畀定一個時間點,畫面就唯一確定。呢一點決定咗後面可唔可以穩定出片。
第四步:聲音,配音亦係成套片嘅時鐘
有旁白嘅片,通常會先做配音,再叫畫面去對齊配音。
Claude 寫好旁白稿,交畀文字轉語音服務朗讀,常見嘅係 ElevenLabs。關鍵係要攞到每個字講出口嘅精確時刻:ElevenLabs 有帶時間戳嘅接口[3],佢返還音頻嘅同時,會畀出每個字符嘅開始同結束時間。如果手頭上係一段現成錄音,就用 Whisper 呢類語音識別工具反推每個詞嘅時間。
有咗呢份時間表,畫面就可以卡住啲說話走:旁白講到「星星」嗰一刻,星星就啱啱彈出嚟。成條配音就成為成套片嘅時鐘,所有動作都按佢嚟排。
音效同音樂都放喺同一個時鐘上:元素彈出配一聲「啵」,轉場配一聲「嗖」,背景音樂墊喺下面,有人講嘢時就調低音量。聲音來源有幾種:
• 音效庫入面嘅現成素材 • AI 音效或者音樂模型。有人叫 Opus 5.5 按品牌規範寫提示詞,交畀 AI 音樂工具 Suno,生成咗一段每分鐘 150 拍嘅配樂同 10 個音效 • 用程式碼合成。有人叫佢做一段 90 秒嘅動態設計演示,入面嘅鋼琴配樂亦係模型自己寫出嚟嘅
MV 嘅情況就反過嚟:首歌已經有咗,首歌本身就係時鐘,畫面跟住歌詞同節拍走,用唔到文字轉語音。
第五步:拍攝同合成,凍結時間,一格一格咁拍
寫好嘅網頁仲未係影片。要變成 MP4,就要有一部「攝錄機」將佢一格一格咁拍落嚟,再同聲音合埋一齊。
呢部攝錄機係無頭瀏覽器(headless browser,冇界面、喺後台運行嘅瀏覽器),通常係 Chrome,由 Puppeteer 呢類自動化工具操作。
佢拍攝時從來唔會撳播放鍵。以 HeyGen 開源嘅 HyperFrames 為例,渲染器[4]會先將畫面跳到第 0 秒,截一張圖;再跳到第 1/30 秒,截第二張。一段 10 秒、每秒 30 格嘅片,就咁截 300 張。每秒格數可以自己定,前面嗰支 MV 用嘅係每秒 24 格,156.6 秒一共約 3760 格。
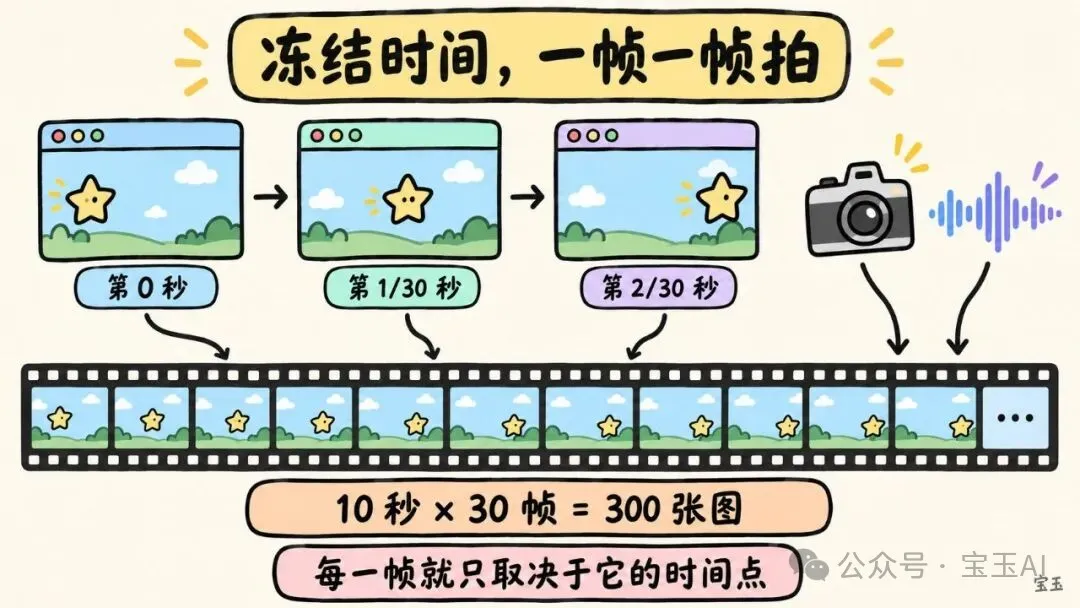
點解唔直接錄屏
瀏覽器為咗流暢,好多嘢都會喺後台異步進行:字體慢慢載入,圖片慢慢解碼,動畫跟住螢幕刷新走。電腦一卡就會掉格,同一份程式碼喺兩部電腦度錄出嚟都可能唔同。
HeyGen 嘅工程師喺文章入面記錄過呢類問題:截圖太快,會截到字體仲未顯示、SVG 仲未上色嘅畫面。佢哋嘅解決辦法係喺 Linux 上用一個特製版本嘅 Chrome,令排版、繪製、截圖喺一次調用入面全部完成,截完呢一格先開始下一格。
畫面入面如果有嵌咗影片素材,亦唔會交畀瀏覽器播放。渲染前先用 FFmpeg 將素材拆成一張張圖片,拍到邊一格,就換上對應嗰張。
程式碼亦要守規矩
為咗令每次拍出嚟都一樣,程式碼有三條禁令:唔可以讀取當前時間,唔可以用冇固定種子嘅隨機數,渲染時唔可以聯網。
守得住呢三條,每一格就只取決於佢嘅時間點,同一份程式碼每次都渲染出完全相同嘅影片。幾千格仲可以分畀多個瀏覽器進程同時渲染,最後再接返埋。
最後合成
收尾交畀 FFmpeg,一個開源嘅音視頻處理工具。佢會將幾千張截圖按順序接成畫面,再混入配音、音效同音樂,輸出一個 MP4 檔案。
現成工具:HyperFrames 同 Remotion
第五步嘅攝錄機唔使自己造,依家有兩個主流開源工具,都可以配合 Claude Code 使用。
HyperFrames[4] 由做數字人影片嘅公司 HeyGen 開源,影片就寫成普通 HTML,動畫預設用 GSAP,渲染靠 Puppeteer 加 FFmpeg。佢畀 Claude Code、Cursor、Codex 呢啲編程智能體準備咗一套技能包(skill,教智能體按固定流程做嘢嘅說明書),將流程定成:規劃、寫 HTML、接入可跳轉嘅動畫、加素材、程式碼檢查、預覽、渲染。
npx skills add heygen-com/hyperframes   # 給智能體裝上技能包
npx hyperframes render                   # 渲染出 MP4
Remotion 出現得更早,用 React 組件寫影片,同樣有官方技能包,喺項目目錄入面運行 npx remotion skills add 就可以裝上。
HeyGen 喺文章入面講,佢哋早期試過 Remotion,發現 React 框架嘅限制加得越多,智能體嘅產出就越保守、越雷同,換返純 HTML 之後,創意先至返嚟。呢個係 HeyGen 自己嘅經驗,揀工具時可以參考。
Claude 點樣檢查自己嘅作品
Opus 5.5 睇唔到影片,但係睇得到圖片。所以佢檢查成品嘅辦法,就係睇渲染出嚟嘅一張張靜態截圖,發現問題再返去改程式碼。
喺 claude.ai 入面,Claude Design 都做到動畫,產出嘅同樣係喺瀏覽器入面運行嘅網頁程式碼;要攞到 MP4 檔案,目前多數係藉助第三方工具逐格渲染。
同 Seedance、可靈呢類影片模型有咩分別
Seedance 係字節嘅影片生成模型,可靈(Kling)係快手嘅,佢哋直接生成像素;Opus 5.5 生成嘅係程式碼。兩條路線擅長嘅嘢正好互補。
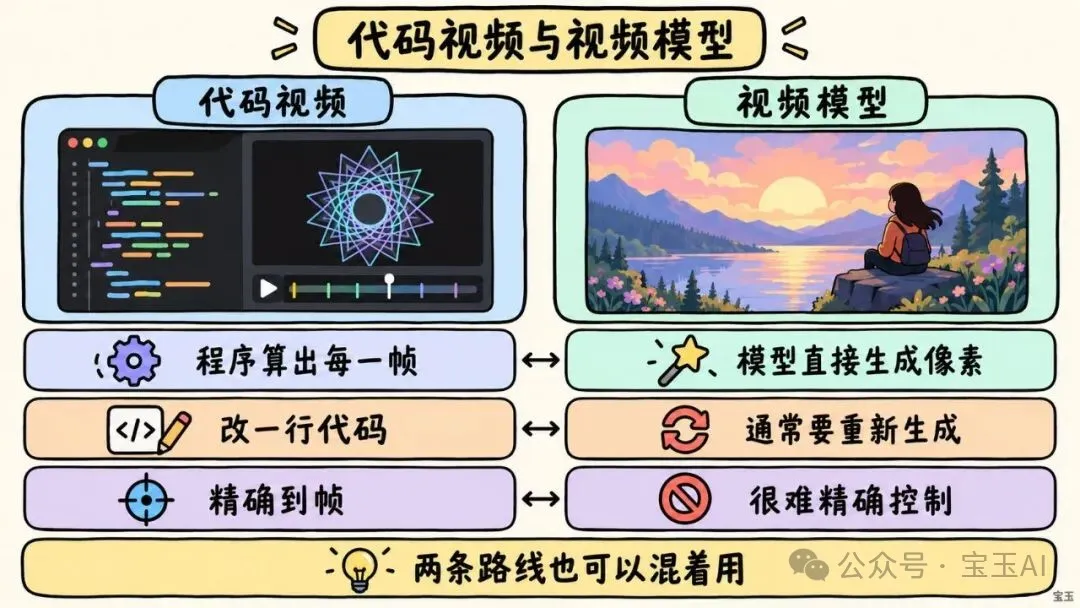
兩條路線亦可以混住用。Claude 可以當編排器(orchestrator),透過 MCP(Model Context Protocol,令 AI 調用外部工具嘅標準協議)去調影片模型,攞返生成好嘅片段,再剪入自己嘅時間軸。
已經有人咁做:用幾張自拍加一段語音備忘錄,透過 MCP 連接嘅工具做出數字人口播影片;或者先用程式碼渲染出鏡頭,再交畀 Runway 嘅 Aleph 模型改成寫實風格。
限制同成本
程式碼影片適合動效、圖表同講解類內容,寫實畫面同大製作仍然有明顯短板。
• 活物畫得唔好:動物同人臉近睇只係粗糙嘅幾何形狀,呢類鏡頭仲係要靠影片模型或者實拍。 • 容易過曝:太空呢類場景常常亮到發白,要喺提示詞入面特別要求真實嘅顏色。 • 額度消耗大:有位創作者做一支 3 分鐘有旁白嘅短片,用咗每週 Claude 額度約 7%;有啲單條提示詞嘅 3D 項目寫到一半,就撞到單次輸出長度嘅上限。如果按 API 計費,Opus 5.5 嘅價格係每百萬輸入 Token 4 美元、每百萬輸出 Token 20 美元。 • 審美要人把關:開發者 Wes Bos 認為,呢啲動效本身唔算出色,出色嘅係佢真係做到出嚟;決定展示咩、將風格做到位仍然係難點,畀佢一套素材庫同風格指引會好很多。 • 有上手門檻:需要一個可以執行程式碼嘅環境,一般係 Claude Code,再裝好 Node.js、Chrome 同 FFmpeg。
總結
Opus 5.5 做影片,分工係咁:佢負責規劃、寫程式碼、調度其他工具,瀏覽器同 FFmpeg 就負責將程式碼變成畫面同檔案。
佢喺影片上嘅表現,來自佢最強嘅兩項能力:長時間規劃同寫程式碼。所以呢類影片文字準、時間準、改得鬱;需要寫實畫面時,再將影片模型接埋入嚟。
參考資料
• Introducing Claude Opus 5.5[1],Anthropic 官方發佈文章 • HTML to Video Was Not Easy: Here's How We Solved It[4],HeyGen 講 HyperFrames 渲染原理嘅工程文章 • Claude Opus 5.5 One-Shot a Music Video: What "Plan a Video" Actually Produces[2],OrcaRouter 對 PDoomVideo 項目嘅拆解 • Claude Opus 5.5 for video[5],daily.dev 對 Heather Cooper 相關文章嘅摘要 • Claude Opus 5.5 generates motion design and visual scenes entirely in code[6],daily.dev 整理嘅社區案例 • Create speech with timestamps[3],ElevenLabs 帶時間戳嘅語音合成接口文檔
引用連結
[1] Anthropic 嘅發佈文章: https://www.anthropic.com/claude-opus-5-5[2] OrcaRouter 嘅拆解文章: https://www.orcarouter.ai/blog/claude-opus-5-5-video-plan-one-shot[3] 帶時間戳嘅接口: https://elevenlabs.io/docs/api-reference/text-to-speech/convert-with-timestamps[4] 渲染器: https://www.heygen.com/research/html-to-video[5] Claude Opus 5.5 for video: https://daily.dev/posts/claude-opus-5-5-for-video-oncuratco[6] Claude Opus 5.5 generates motion design and visual scenes entirely in code: https://daily.dev/posts/claude-opus-5-5-generates-motion-design-and-visual-scenes-entirely-in-code-yqmdx7qnw
先說結論:視頻是 Opus 5.5 寫的程序畫出來的
2026 年 9 月 22 日,Anthropic 發佈了 Claude Opus 5.5。之後一週,社交媒體上冒出一大批“一句話做出來”的動畫視頻:15 秒的動效作品集、帶旁白的科普短片、配了鋼琴曲的動態設計,還有一支兩分半鐘的 MV。
看到這些視頻,有人以為 Claude 也有了視頻模型,也有人以為 AI 寫幾行代碼,視頻就自己冒出來了。這兩種理解都不準確。
Opus 5.5 能讀文字、圖片和文件,但看不了視頻,輸出也只有文字。那些視頻全是它寫的程序畫出來的:程序規定每一幀長什麼樣,瀏覽器或渲染軟件按程序把幾千幀逐一畫好,再拼成一個 MP4 文件。
Anthropic 的發佈文章[1]裏也沒有提到任何視頻能力,重點講的是寫代碼、操作電腦和知識工作。所以更準確的說法是:做這些視頻時,Opus 5.5 身兼導演和程序員兩個角色。
我做這條視頻用的提示詞
我也做了一條教學視頻,和這篇文章一起發。下面是我製作這條視頻時使用的提示詞:
幫我做一個教學視頻,素材(Markdown 文件)和 Gemini API Key(.env 文件)見附件。
使用 JS + Canvas 繪製,手繪卡通風格,有動效,配音使用 Gemini 3.8 Flash TTS。
要通俗易懂,開頭要吸引人,看完有收穫。
這段提示詞交代了素材、繪製方式、視覺風格、配音工具和內容要求。JS + Canvas 對應前面說的代碼視頻路線:畫面由程序繪製,配音交給語音工具。最後一句則明確了教學視頻要達到的效果:吸引人看下去,也讓人看懂、記住。
原理:寫程序,逐幀拍照,拼成視頻
視頻就是一串連續播放的靜態圖片。常見的是每秒 30 張(30 幀),10 秒的視頻就是 300 張圖,播得夠快,人眼就看成了連貫的動作。
所以做一段視頻,要回答的問題只有一個:第 N 幀應該長什麼樣。Opus 5.5 做的事,就是寫一個能回答這個問題的程序。隨便給它一個時間點,比如第 2.5 秒,它就能畫出這一刻的完整畫面。
整個流程可以拆成五步:規劃、畫面、動作、聲音、拍攝與合成(圖裏把拍攝和合成畫成了兩格)。先看全流程圖,後面再逐步拆開講。
帶底色的三步是 Opus 5.5 寫的代碼,其餘是外部工具。配音有兩個去處:給動作提供時間表,也作為音軌交給 FFmpeg。
第一步:規劃,先寫腳本和分鏡
收到“幫我做個視頻”這樣的需求,Opus 5.5 先寫腳本,再把腳本拆成一個個鏡頭,也就是分鏡。每個鏡頭要寫清楚畫什麼、持續多久、配什麼話。
公開了全部源碼的一個例子,是一支叫《I'm Upping My P(doom)》的 MV,時長 156.6 秒,項目名 PDoomVideo,源碼放在 GitHub 上(OrcaRouter 的拆解文章[2])。作者在說明文件裏寫,他只指定了一個角色形象,要求每句歌詞都配上有趣的畫面和轉場,沒有給任何具體場景,其餘全部由模型生成。
模型第一輪做完後,給自己寫了一份分鏡規範 STORYBOARD.md,裏面規定了:
• 固定的角色設計,整片不變 • 配色從暖奶油色到太空紫,再到警報紅,最後回來 • 每個鏡頭裏都必須有東西在動,畫面裏不放文字 • 角色表情要漸變過去,不能突然跳變 • 每次切換鏡頭都要由動作帶出來,比如一口咬下去黑屏、一次墜落、鏡頭穿過一隻眼睛
然後它按章節分工:同時派出多個子智能體(subagent,主智能體派出去分頭幹活的副手),每個子智能體寫一個 JavaScript 文件,負責時間軸上的一段。
說明文件也寫了,這支視頻前後生成了兩輪。網上說的“一句話一次成型”,指的是用戶只發了一句話;模型自己在內部完成了規劃、分工和返工。這正是 Opus 5.5 的強項:長時間、多文件的任務能一直不跑偏。Anthropic 的發佈文章裏提到,有測試者讓它無人值守連續幹了 18 個多小時。
第二步:畫面,用代碼畫出來
畫面裏的形狀、顏色和角色,都由代碼描述,不需要現成的圖片素材。
最常見的寫法是網頁。文字和色塊用 HTML、CSS 排版,圖標和角色用 SVG 畫(SVG 是一種用座標和數學描述圖形的格式,放大也不會模糊)。比如下面這段 SVG,畫的是一個青色的圓、一顆金色的五角星和一個方塊身體:
<svg width="400" height="200">
  <circle cx="60" cy="100" r="40" fill="teal" />
  <polygon points="200,60 212,95 250,95 219,117 231,152 200,130 169,152 181,117 150,95 188,95" fill="gold" />
  <rect x="300" y="80" width="60" height="50" rx="6" fill="#d97757" />
</svg>
做 3D 場景時,常用網頁 3D 庫 three.js,整個場景往往就寫在一個 HTML 文件裏。前面那支 MV 用的是 p5.js(一個面向藝術創作的繪圖庫),再加上一個水彩筆刷庫,所以畫面有手繪感。
也有不經過網頁的路線。有人讓 Opus 5.5 用 Manim 做編程知識講解視頻,Manim 是一個專門做數學動畫的 Python 庫。開發者 Felix Rieseberg 把 3D 軟件 Blender 當成 Python 庫來用,讓模型直接寫腳本建模、做貼圖。這類工具自己就能渲染出畫面。
需要照片級素材時,也可以先讓圖像模型生成圖片,再放進網頁裏用。
第三步:動作,把每個動作固定在時間點上
畫面能動,是因為代碼裏有一張時間表:第幾秒,哪個東西,怎麼動。常見的寫法有兩種。
第一種用 GSAP,一個老牌的網頁動畫庫。它的每一行都是一條指令,下面兩行的意思是“第 2 秒星星從無到有彈出來,第 3 秒角色向右走 400 像素”:
tl.from(star, { scale: 0 }, 2)
tl.to(character, { x: 400 }, 3)
GSAP 的時間軸可以暫停,也可以直接跳到任意一個時間點,後面“逐幀拍照”那一步正需要這個能力。開源工具 HyperFrames 默認用的就是它。
第二種是 Remotion 的寫法。Remotion 是一個用 React 寫視頻的框架,每一幀都是幀號的函數:代碼拿到“現在是第幾幀”,算出這一幀裏每個元素的位置、透明度和顏色。
兩種寫法最後達到的效果相同:給定一個時間點,畫面就唯一確定。這一點決定了後面能不能穩定出片。
第四步:聲音,配音也是全片的時鐘
帶旁白的視頻,一般先做配音,再讓畫面去對齊配音。
Claude 寫好旁白稿,交給文字轉語音服務朗讀,常見的是 ElevenLabs。關鍵是拿到每個字說出口的精確時刻:ElevenLabs 有帶時間戳的接口[3],返回音頻的同時,會給出每個字符的開始和結束時間。如果手上是一段現成的錄音,就用 Whisper 這類語音識別工具反推每個詞的時間。
有了這份時間表,畫面就能卡着話走:旁白說到“星星”的那一刻,星星正好彈出來。整條配音就成了全片的時鐘,所有動作都按它排。
音效和音樂也放在同一個時鐘上:元素彈出配一聲“啵”,轉場配一聲“嗖”,背景音樂墊在下面,有人說話時調低音量。聲音的來源有好幾種:
• 音效庫裏的現成素材 • AI 音效或音樂模型。有人讓 Opus 5.5 按品牌規範寫提示詞,交給 AI 音樂工具 Suno,生成了一段每分鐘 150 拍的配樂和 10 個音效 • 用代碼合成。有人讓它做一段 90 秒的動態設計演示,裏面的鋼琴配樂也是模型自己寫出來的
MV 的情況反過來:歌曲已經有了,歌曲本身就是時鐘,畫面跟着歌詞和節拍走,用不到文字轉語音。
第五步:拍攝與合成,凍結時間,一幀一幀拍
寫好的網頁還不是視頻。要變成 MP4,得有一台“攝像機”把它一幀一幀拍下來,再和聲音合在一起。
這台攝像機是無頭瀏覽器(headless browser,沒有界面、在後台運行的瀏覽器),通常是 Chrome,由 Puppeteer 這類自動化工具來操作。
它拍攝時從不按播放鍵。以 HeyGen 開源的 HyperFrames 為例,渲染器[4]先把畫面跳到第 0 秒,截一張圖;再跳到第 1/30 秒,截第二張。一段 10 秒、每秒 30 幀的視頻,就這樣截 300 張。幀率可以自己定,前面那支 MV 用的是每秒 24 幀,156.6 秒一共約 3760 幀。
為什麼不直接錄屏
瀏覽器為了流暢,很多事情是在後台異步進行的:字體慢慢加載,圖片慢慢解碼,動畫跟着屏幕刷新走。電腦一卡就會掉幀,同一份代碼在兩台電腦上錄出來也可能不一樣。
HeyGen 的工程師在文章裏記錄過這類問題:截圖太快,會截到字體還沒顯示、SVG 還沒上色的畫面。他們的解決辦法是在 Linux 上用一個特製版本的 Chrome,讓排版、繪製、截圖在一次調用裏全部完成,截完這一幀才開始下一幀。
畫面裏如果嵌了視頻素材,也不交給瀏覽器播放。渲染前先用 FFmpeg 把素材拆成一張張圖片,拍到哪一幀,就換上對應的那張。
代碼也要守規矩
為了讓每次拍出來都一樣,代碼有三條禁令:不能讀取當前時間,不能用沒有固定種子的隨機數,渲染時不能聯網。
守住這三條,每一幀就只取決於它的時間點,同一份代碼每次都渲染出完全相同的視頻。幾千幀還可以分給多個瀏覽器進程同時渲染,最後再接起來。
最後合成
收尾交給 FFmpeg,一個開源的音視頻處理工具。它把幾千張截圖按順序接成畫面,再混入配音、音效和音樂,輸出一個 MP4 文件。
現成工具:HyperFrames 和 Remotion
第五步的攝像機不用自己造,現在有兩個主流的開源工具,都能配合 Claude Code 使用。
HyperFrames[4] 由做數字人視頻的公司 HeyGen 開源,視頻就寫成普通 HTML,動畫默認用 GSAP,渲染靠 Puppeteer 加 FFmpeg。它給 Claude Code、Cursor、Codex 這些編程智能體準備了一套技能包(skill,教智能體按固定流程幹活的說明書),把流程定成:規劃、寫 HTML、接入可跳轉的動畫、加素材、代碼檢查、預覽、渲染。
npx skills add heygen-com/hyperframes   # 給智能體裝上技能包
npx hyperframes render                   # 渲染出 MP4
Remotion 出現得更早,用 React 組件寫視頻,同樣有官方技能包,在項目目錄裏運行 npx remotion skills add 就能裝上。
HeyGen 在文章裏說,他們早期試過 Remotion,發現 React 框架的限制加得越多,智能體的產出越保守、越雷同,換回純 HTML 後,創意才回來。這是 HeyGen 自己的經驗,選工具時可以參考。
Claude 怎麼檢查自己的作品
Opus 5.5 看不了視頻,但能看圖片。所以它檢查成品的辦法,是看渲染出來的一張張靜態截圖,發現問題再回去改代碼。
在 claude.ai 裏,Claude Design 也能做動畫,產出的同樣是在瀏覽器裏運行的網頁代碼;要拿到 MP4 文件,目前多是藉助第三方工具逐幀渲染。
和 Seedance、可靈這類視頻模型有什麼區別
Seedance 是字節的視頻生成模型,可靈(Kling)是快手的,它們直接生成像素;Opus 5.5 生成的是代碼。兩條路線擅長的事情正好互補。
兩條路線也可以混着用。Claude 可以當編排器(orchestrator),通過 MCP(Model Context Protocol,讓 AI 調用外部工具的標準協議)去調視頻模型,拿回生成好的片段,再剪進自己的時間軸。
已經有人這麼做:用幾張自拍加一段語音備忘錄,通過 MCP 連接的工具做出數字人口播視頻;或者先用代碼渲染出鏡頭,再交給 Runway 的 Aleph 模型改成寫實風格。
侷限與成本
代碼視頻適合動效、圖表和講解類內容,寫實畫面和大製作仍有明顯短板。
• 活物畫不好:動物和人臉近看只是粗糙的幾何形狀,這類鏡頭還得靠視頻模型或實拍。 • 容易過曝:太空這類場景常常亮得發白,要在提示詞裏專門要求真實的顏色。 • 額度消耗大:一位創作者做一支 3 分鐘帶旁白的短片,用掉了每週 Claude 額度的約 7%;有的單條提示詞的 3D 項目寫到一半,就撞上了單次輸出長度的上限。按 API 計費的話,Opus 5.5 的價格是每百萬輸入 Token 4 美元、每百萬輸出 Token 20 美元。 • 審美要人把關:開發者 Wes Bos 認為,這些動效本身並不算出色,出色的是它能做出來;決定展示什麼、把風格做到位仍然是難點,給它一套素材庫和風格指引會好很多。 • 有上手門檻:需要一個能執行代碼的環境,一般是 Claude Code,再裝好 Node.js、Chrome 和 FFmpeg。
總結
Opus 5.5 做視頻,分工是這樣的:它負責規劃、寫代碼、調度其他工具,瀏覽器和 FFmpeg 負責把代碼變成畫面和文件。
它在視頻上的表現,來自它最強的兩項能力:長時間規劃和寫代碼。所以這類視頻文字準、時間準、改得動;需要寫實畫面時,再把視頻模型接進來。
參考資料
• Introducing Claude Opus 5.5[1],Anthropic 官方發佈文章 • HTML to Video Was Not Easy: Here's How We Solved It[4],HeyGen 講 HyperFrames 渲染原理的工程文章 • Claude Opus 5.5 One-Shot a Music Video: What "Plan a Video" Actually Produces[2],OrcaRouter 對 PDoomVideo 項目的拆解 • Claude Opus 5.5 for video[5],daily.dev 對 Heather Cooper 相關文章的摘要 • Claude Opus 5.5 generates motion design and visual scenes entirely in code[6],daily.dev 整理的社區案例 • Create speech with timestamps[3],ElevenLabs 帶時間戳的語音合成接口文檔
引用連結
[1] Anthropic 的發佈文章: https://www.anthropic.com/claude-opus-5-5[2] OrcaRouter 的拆解文章: https://www.orcarouter.ai/blog/claude-opus-5-5-video-plan-one-shot[3] 帶時間戳的接口: https://elevenlabs.io/docs/api-reference/text-to-speech/convert-with-timestamps[4] 渲染器: https://www.heygen.com/research/html-to-video[5] Claude Opus 5.5 for video: https://daily.dev/posts/claude-opus-5-5-for-video-oncuratco[6] Claude Opus 5.5 generates motion design and visual scenes entirely in code: https://daily.dev/posts/claude-opus-5-5-generates-motion-design-and-visual-scenes-entirely-in-code-yqmdx7qnw